pg_mooncake:基于列存表与 DuckDB 的 Postgres 极速分析引擎

pg_mooncake 将列存表(Columnstore Tables)与 DuckDB 向量化执行引擎引入 PostgreSQL,以实现极速分析查询。
它像普通 Postgres 表一样支持事务性的 INSERT、UPDATE 和 DELETE。底层数据以 Parquet 文件配合 Delta Lake(以及 v0.2+ 中的 Apache Iceberg)表元数据写入,因此也可以在 Postgres 外部直接查询。
为什么还需要另一个 Postgres 分析扩展?
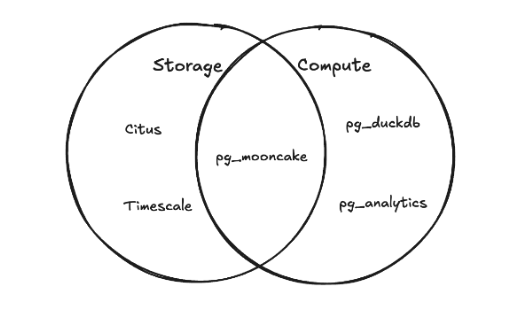
PostgreSQL 是当今最受欢迎的数据库,但它在分析型查询(OLAP)上的表现并不理想。业界曾有过许多尝试,但收效有限。极速分析需要一整套截然不同的底层技术,例如列式存储(Columnar Storage)、向量化执行(Vectorized Execution)和延迟物化(Late Materialization)。早期的 Citus 与 Timescale 等项目为 Postgres 添加了列式存储,但缺乏优秀的向量化执行引擎来充分发挥列存格式的威力。
如果在十年前,从头编写一套向量化执行引擎会是一个浩大的工程;但在今天,我们有了 DuckDB。
对于还不熟悉 DuckDB 的读者,可以将它理解为“分析领域的 SQLite”。它专为嵌入宿主进程而设计(在我们的场景下宿主就是 Postgres)。它的分析速度极快,在 ClickBench 基准测试中名列前茅;并且它的 SQL 语法与 Postgres 高度兼容,大大降低了集成难度。
近期我们看到将 DuckDB 嵌入 Postgres 的趋势正在兴起。像 pg_duckdb 和 pg_analytics 这样的扩展旨在从 Postgres 中查询外部列式存储,但它们无法通过事务性的 INSERT / UPDATE / DELETE 直接写出这些开放格式的数据。
pg_mooncake 则同时带来了支持事务读写的列存表以及能够充分利用该格式的向量化计算引擎。
pg_mooncake 是如何构建的
首先要做的决定是选择存储格式。虽然私有格式可以针对单一引擎做极致优化,但开放格式允许跨引擎共享数据——就像月饼生来就是为了与朋友分享一样。pg_mooncake 选择 Parquet 作为数据文件格式,并附上 Iceberg 与 Delta Lake 等开放表格式元数据,从而确保任何主流计算引擎都能直接读取 Mooncake 表。
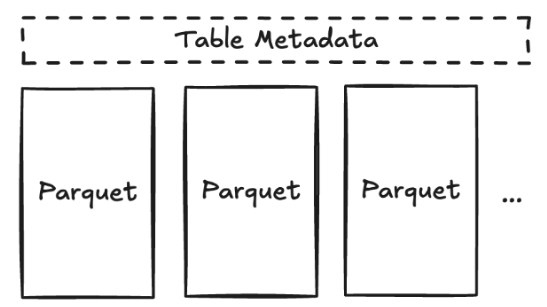
对表的操作可以视为对这些底层 Parquet 文件的操作:INSERT 与 COPY 会生成新的 Parquet 文件,UPDATE 与 DELETE 则会移除旧文件并生成包含修改的新文件(在后续的 v0.2 / v0.3 架构中,我们引入了基于 Puffin 的位置删除向量 Deletion Vectors,无需重写原文件即可标记删除行)。
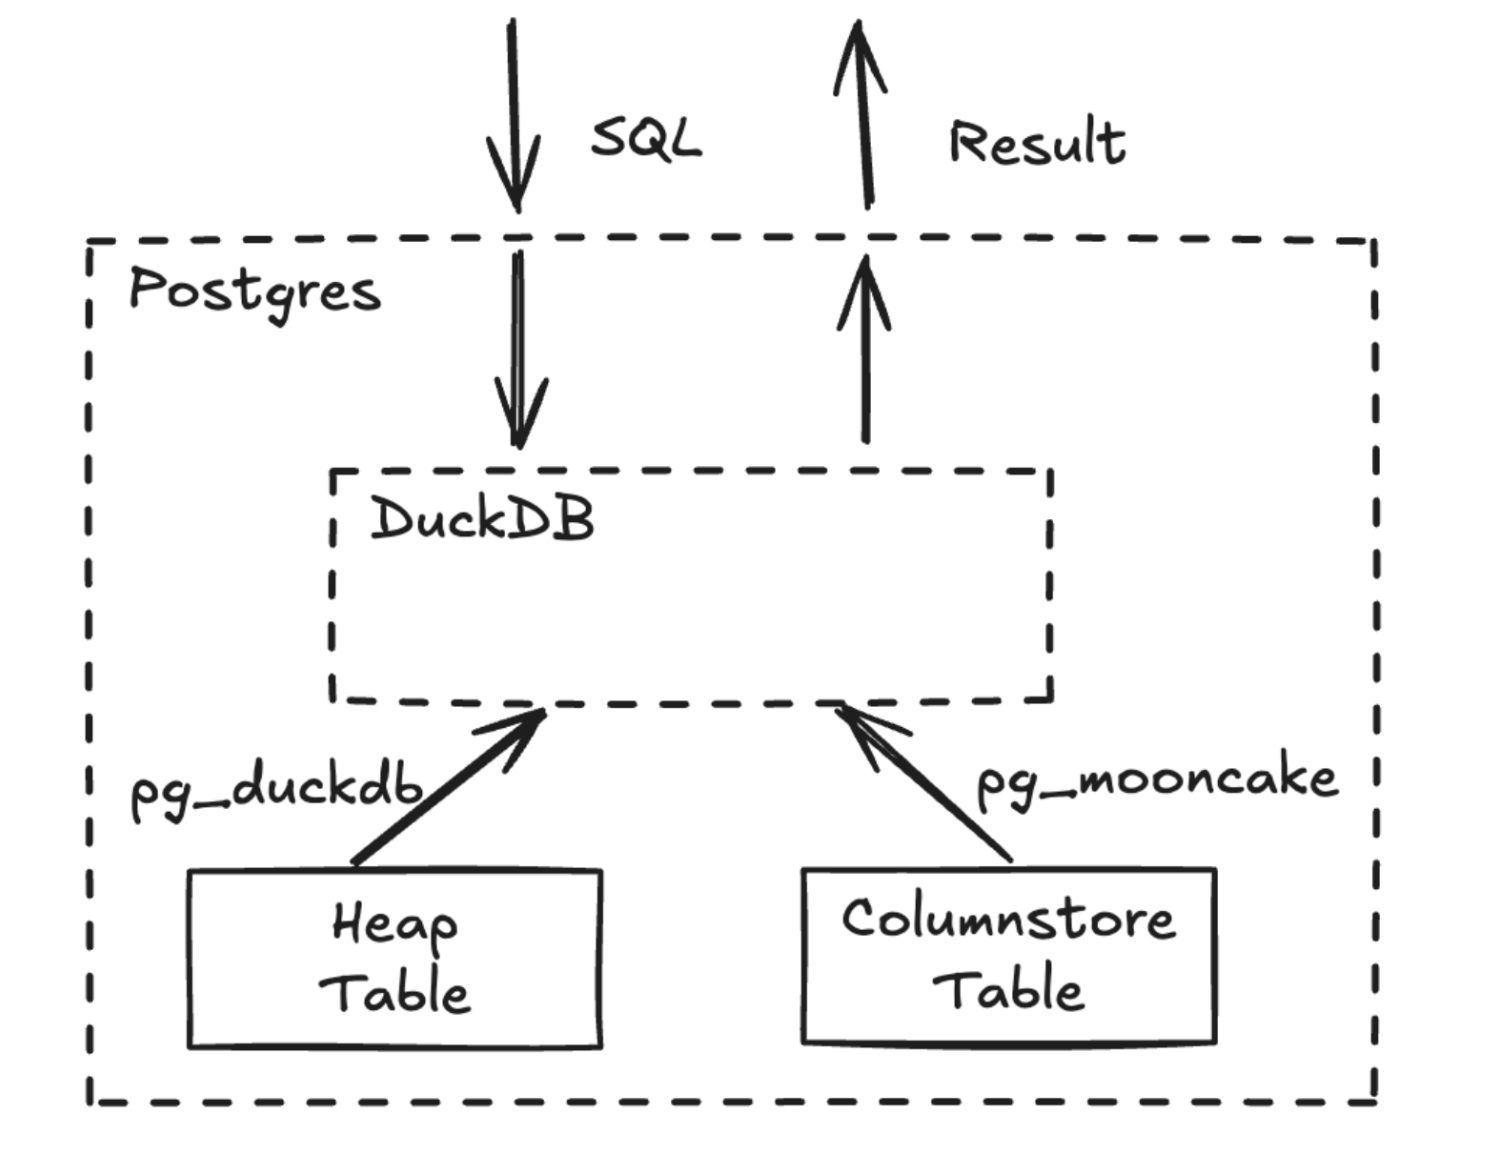
在底层核心上,pg_mooncake(v0.1)由两部分组成:Postgres 内部的列存表访问方法(TAM)接口 + DuckDB 内部的 Parquet 存储扩展(duckdb_mooncake)。表的元数据(包括 Parquet 文件的新增与删除记录)直接存储在 Postgres 系统表中以保证事务一致性。涉及列存表的查询会从 Postgres 路由至 DuckDB 执行,并将结果流式返回给 Postgres。
这种深度集成之所以成为可能,得益于 DuckDB 与 Postgres 极强的可扩展性——两者都允许开发者自定义存储层、查询规划器(Planner)和执行器(Executor)。
查询生命周期(Query Lifetime)
让我们来看看一条查询在 pg_mooncake 中的完整生命周期。
当一条 SQL 查询到达 Postgres 时,Postgres 先对其进行解析并生成查询计划。当检测到查询涉及列存表时,该查询会被识别为分析型查询,交由 DuckDB 全权执行,并将结果流式传回 Postgres,期间会自动完成细微的 SQL 语法改写。
我们在 DuckDB 中注册了自定义存储扩展(duckdb_mooncake),实现了 TableScan、Insert、Update、Delete 等物理算子。此外,由于 pg_duckdb 实现了对普通 Postgres 堆表的读取能力,我们的列存表可以在 DuckDB 引擎内部直接与普通 Postgres 表执行高速关联查询(JOIN)。
事务性更新与删除
为了支持 DELETE 与 UPDATE,TableScan 期间会填充一个隐式的 row_id 列,由 (file_id, row_offset) 组成,用于精确定位每一行。物理删除算子会记录所有被标记删除的 row_id,并在读取受影响的 Parquet 文件时过滤掉已删除行;物理更新算子则将更新后的行流式写入新 Parquet 文件,并标记旧行的 row_id 为已删除。
所有表元数据(包括 Parquet 文件的增删与统计信息)都保存在 Postgres 表中,从而天然具备 ACID 事务保证。DuckDB 在执行 SQL 查询时会获取对应的 Postgres 快照(Snapshot),并从该快照读取元数据以保证强一致性。
下一步计划
我们将持续打磨 pg_mooncake,使其真正达到生产级就绪状态。文件合并(Compaction)、二级索引与约束、分区表支持等功能均已在路线图中。
作为一家初创公司,Mooncake Labs 的目标是打造面向开发者的湖仓一体(Lakehouse)架构——用简洁的 Postgres 与 Python 接口彻底简化现代数据栈,而 pg_mooncake 正是迈向这一愿景的第一步。
🥮